


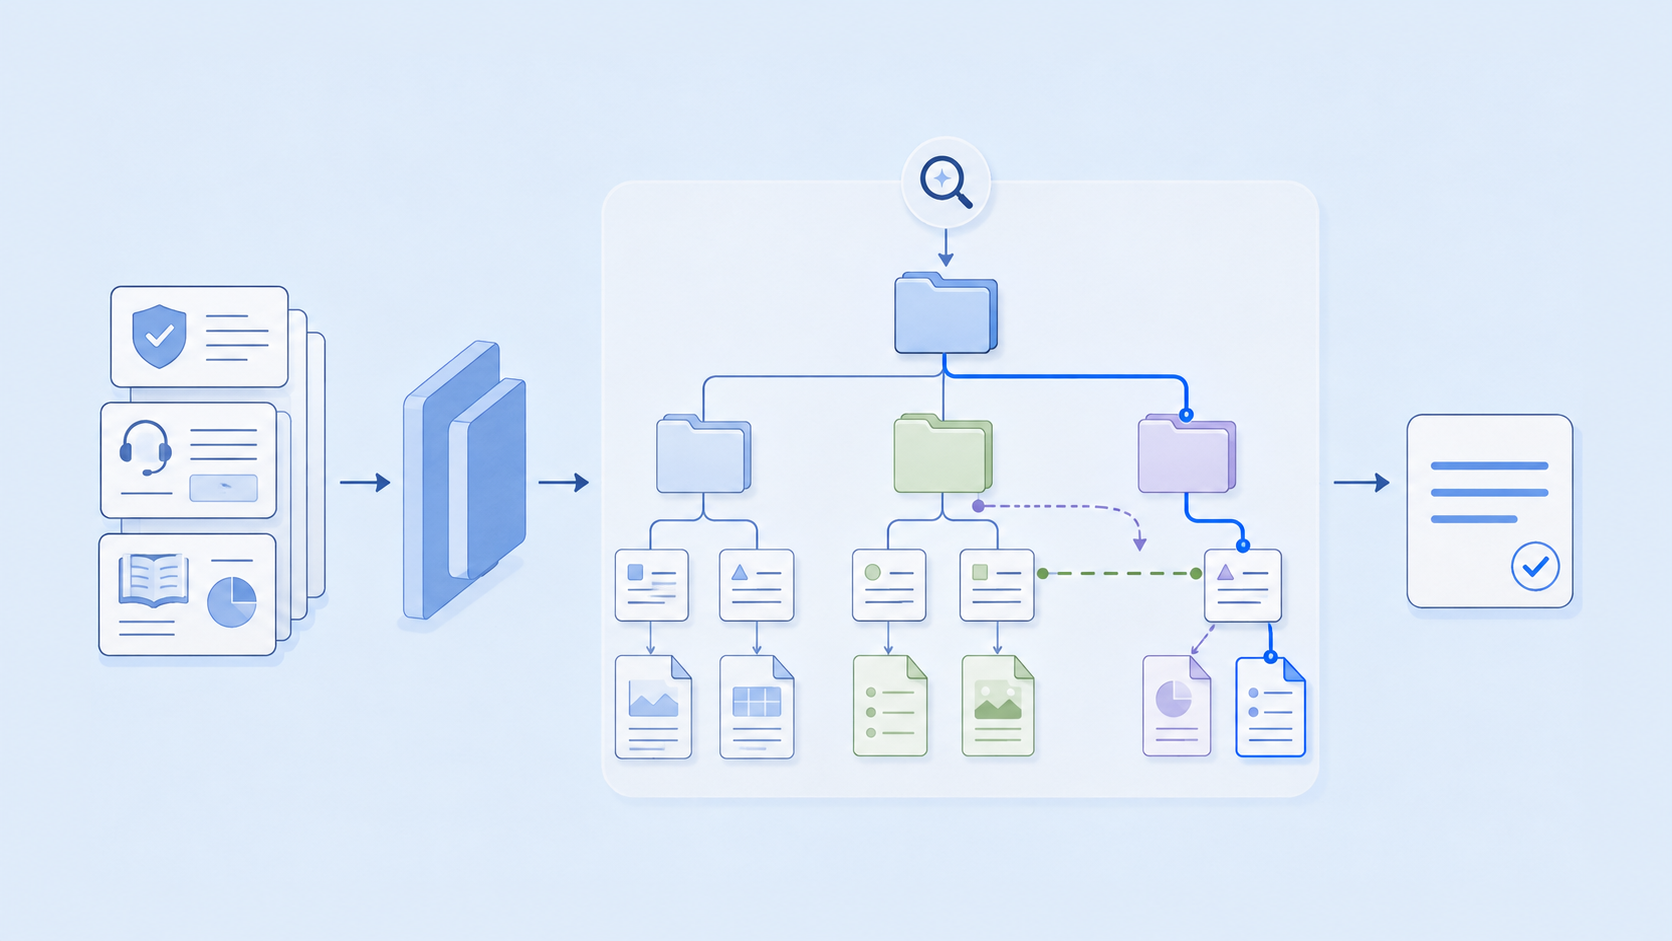

Retrieval-Augmented Generation(RAG)は、言語モデルが外部の根拠情報を参照できるようにする仕組みです。クエリを埋め込み表現に変換し、類似する文章を検索し、その結果をコンテキストとしてモデルに与えて回答を生成します。このシンプルなパターンは、企業向けの質問応答、カスタマーサポート、ナレッジに基づくAIアシスタントなどで広く利用されています。
しかし、従来のRAGでは、モデルは基本的に検索結果を受け取るだけの「受動的な利用者」です。モデルから見えるのはリトリーバーが返した文章だけであり、ナレッジベース全体がどのように整理されているのか、まだ探索していないトピックは何か、別の領域により適切な根拠が存在するのかまでは把握できません。
Agentic RAGでも、多くの場合は「検索を繰り返せるようになった」だけです。エージェントは追加のクエリを発行できますが、コーパス全体の地図を持たないまま、何を検索すべきかを推測し続ける必要があります。
私たちの新しい論文では、Corpus2Skill というシステムレベルの検索アーキテクチャを提案します。これは、LLMエージェントと範囲が限定されたナレッジベースとのインターフェースそのものを変えるものです。
オフラインのコンパイラがコーパスを階層型の「情報スキル」ディレクトリへ変換し、推論時にはエージェントがそのディレクトリをナビゲートします。まず全体像を確認し、段階的に詳細な要約へ進み、最終的に元のドキュメントを取得します。最初に選んだ経路が有効でなければ、戻ったり、別のブランチへ移動したりすることもできます。
中心となる考え方はシンプルです。
構造化されたコーパスでは、知識を「検索可能」にするだけでなく、「ナビゲーション可能」にする。
検索からナビゲーションへ
従来のRAGでは、モデルに与えられるのは上位にランクされた固定数の文章です。必要な根拠がその中に含まれていなかった場合、モデルは他にどのような情報が存在するのか、次にどこを探せばよいのかを判断できないことがあります。
Corpus2Skillでは、コーパスの構造そのものをエージェントに公開します。
各トップレベルのスキルは、幅広いトピック領域を表します。その内部では INDEX.md がさらに細かなグループを説明し、最終的には個々のドキュメントを表す行までたどることができます。
最初に表示されるのは軽量な説明だけです。より詳細な要約や元ドキュメントは、エージェントが必要だと判断した場合にのみ読み込まれます。
この**段階的開示(progressive disclosure)**の設計により、ナレッジベース全体をコンテキストウィンドウへ投入することなく、エージェントに探索計画を立てるための十分な情報を与えられます。
エージェントは複数の候補ブランチを同時に検討し、それぞれのカバレッジを比較できます。有望でない経路を途中で見切ったり、エンティティベースのクロスリンクをたどったり、階層内の異なる場所から得た情報を組み合わせたりすることも可能です。
したがって、Corpus2Skillは単なる新しいリトリーバーではありません。
階層構造、クロスリンク、そしてエージェントの探索行動を一つのシステムとして統合した、compile-then-navigate(コンパイルしてからナビゲートする)アーキテクチャです。
オフラインコンパイラ:コーパスをスキルへ変換する
Corpus2Skillでは、最初に一度だけコンパイル処理を行います。
各ソースドキュメントから、以下を含むコンパクトなサマリーカードを生成します。
- タイトル
- 1行の説明
- 特徴的なフレーズ
このカードを元のテキストと組み合わせて埋め込み表現を作成することで、クラスタリング時に意味的な情報と表層的な情報の両方を利用できます。
続いて、関連する項目を繰り返しクラスタリングし、それぞれのグループについてLLMに要約を生成させます。このボトムアップの処理によって、多層的なトピック階層が構築されます。
階層が確定すると、Corpus2Skillはそれをファイルシステム上のスキルディレクトリ群として具体化します。
- 各トップレベルのトピックを
SKILL.mdとして作成 - 中間グループおよびリーフグループを
INDEX.mdとして作成 - 完全なソースドキュメントは別のドキュメントストアに保持
- ブランチをまたぐ情報は、エンティティインデックスと関連スキルリンクで接続
さらに、エージェントが階層を活用しやすくするため、3つの拡張機能を加えています。
Soft assignment では、1つのドキュメントが複数のクラスタに属する可能性がある場合に、複数の場所から参照できるようにします。
Exemplars では、それぞれのブランチを代表するドキュメント例を提示します。
Entity index を利用すると、製品名、組織名、機能名など特定のエンティティに関連するスキルへ直接移動できます。
ナビゲーション用のファイルは通常 2 KB未満と小さいため、エージェントは完全なドキュメントを読み込む前に、低コストで要約を確認できます。
サーブフェーズ:地図をたどり、根拠を取得する
クエリを受け取ると、エージェントはまず利用可能なスキルの名前と短い説明を確認します。これがコーパス全体を俯瞰するための「鳥瞰図」になります。
一般的なクエリでは、2〜3回程度のナビゲーションで必要な情報へ到達します。
- エージェントが有望なトップレベルスキルを1つ以上選択する
- 関連する
SKILL.mdを読み、さらにINDEX.mdのサブグループへ進む - 1つ以上の完全なドキュメントを取得し、それらを基に回答を生成する
最初に選んだブランチから有用な情報が得られなければ、エージェントは引き返すことができます。
クエリが複数のトピックにまたがる場合は、関連スキルリンクやエンティティインデックスを利用し、異なるブランチから得た根拠を組み合わせることもできます。
重要なのは、システムが最終的な主張の根拠を、ルーティング用の要約ではなく、実際に取得したソースドキュメントへ紐付けることを要求している点です。
つまり、
要約は「どこを探すべきか」を判断するために使い、ソースドキュメントは「何を主張できるか」を決めるために使います。
Corpus2Skillでは、一般的なファイルナビゲーションとドキュメント取得ツールを利用します。サーブ時にベクトルデータベースを必要とせず、生成されたディレクトリはファイルシステムベースのスキルをサポートする既存のエージェント環境にも統合できます。
企業向け質問応答での評価
まず、企業向けカスタマーサポートのベンチマークである WixQA を用いてCorpus2Skillを評価しました。
WixQAには、6,221件のサポート記事と、専門家が作成した200件のテストクエリが含まれています。
コンパイラによって、6つのトップレベルスキルと665個のナビゲーションファイルからなる3階層の構造が生成されました。
比較対象として、異なる検索方式をカバーする以下の5つのベースラインを使用しました。
- BM25によるキーワード検索
- Dense Vector Retrieval
- Sparse–Dense Hybrid Retrieval
- RAPTORによる階層型検索
- Sparse、Dense、Hybrid検索ツールへ反復的にアクセスできるエージェント
すべてのシステムで同じ回答モデルと評価プロトコルを使用しました。
評価指標には、語彙的・意味的な回答品質、事実性、コンテキストのRecallとPrecision、根拠に対するFaithfulness、Hallucination Rate、ターン数、クエリあたりのコストなどを使用しています。
結果:回答品質と根拠カバレッジの両方を改善
WixQAでは、Corpus2Skillがすべての回答品質指標、および両方の検索カバレッジ指標で最高スコアを記録しました。
Token F1は 0.456 に達しました。
これは、0.378だったAgentic Retrievalベースラインと比べて相対的に21%向上、0.364だったDense Retrievalと比べて25%向上しています。
RAPTORに対する差は統計的にも有意であり、3回の独立したサーブ実験におけるスコアのばらつきもわずか ±0.002 でした。
Factualityは 0.767 に達し、次点の手法を約6ポイント上回りました。
Context RecallとPrecisionはそれぞれ 0.708、0.829 となり、RAPTORの0.618、0.659を上回っています。
この結果は、エージェントが単により流暢な回答を生成しているだけではなく、より完全で関連性の高い根拠ドキュメントを発見できていることを示しています。
制約のないAgentic Searchと比較すると、Groundingも大きく改善しました。
論文で使用した厳格な閾値では、AgenticベースラインはWixQAのクエリの50%でハルシネーションを起こしました。一方、Corpus2Skillでは、その割合が 4.5% まで低下しました。
Single-shot Retrievalは、モデルに与える文章が少数の固定パッセージに限定されるため、一部のGrounding指標ではわずかに優れています。しかし、回答品質と根拠カバレッジではCorpus2Skillを大きく下回ります。
一方で、トレードオフとなるのがコストです。
Prompt Cachingを使用した場合、Corpus2Skillのコストは1クエリあたり0.153ドルでした。
これはAgenticベースラインの約1.9倍、Single-shot Retrieverの約13〜22倍にあたります。
より小さなサーブモデルを利用すると、F1向上の大部分を維持しながらコストを0.093ドルまで下げられますが、Grounding性能は低下します。
したがって、この手法は特に、回答の完全性や事実的根拠に追加のナビゲーションコストをかける価値がある、高価値な質問に適しています。
ナビゲーションが有効な場合と、そうでない場合
Corpus Navigationは、すべての検索方式を置き換える万能な手法ではありません。
WixQAに加え、RAGBenchの10個のサブセットでも同じシステムを評価し、合計11データセットで検証しました。
対応のある有意差検定では、Corpus2Skillは
- 5データセットで勝利
- 3データセットで同等
- 3データセットで敗北
という結果になりました。
性能の傾向は、基となるコーパスの性質と対応しています。
- ナビゲーションが最も有効なのは、範囲が限定された単一ドメインのコレクションで、復元可能なトピック分類構造があり、各ドキュメントが明確な機能やトピックを扱っている場合です。
- 性能が同等になりやすいのは、異質なドキュメントが混在するコレクションや数値テーブル中心のコレクションなど、単一の整理方法では一貫した優位性が得られない場合です。
- Flat Retrievalの方が適しているのは、オープンドメインのFactoidデータ、ほぼ同一形式のテーブルが大量に含まれる均質なコレクション、あるいは多数の条項タイプに分割された長文ドキュメントなどです。
性能が低下したケースでは、トップレベルの要約が一般的になりすぎたり、互いにほとんど区別できなくなったりするため、階層構造そのものが有効なルーティングシグナルを提供できません。
これは実運用における重要な設計指針になります。
コーパスをスキルへ変換すべきなのは、その構造がエージェントによるナビゲーションに十分な意味を持つ場合です。
性能向上を生み出している要因
Ablation Studyの結果から、性能向上の主な要因はモデルサイズではなく、ナビゲーション可能性そのものであることが分かりました。
Entity Indexを削除すると、WixQAのF1は0.456から 0.312 まで低下しました。
Soft Assignmentを削除すると 0.333、Branch Exemplarsを削除すると 0.401 まで低下します。
一方、コンパイル時に使用するEncoderを13分の1のサイズのモデルへ置き換えても、性能への影響はほとんどありませんでした。
また、この階層構造は予測可能な形でスケールします。
コーパスを5,000件から50,000件のドキュメントへ拡大しても、追加されるナビゲーション階層はわずか1レベルでした。
50,000ドキュメントを使用した実験でも、すべてのクエリが問題なく大規模なツリーを探索でき、ドキュメント数の増加に伴う性能低下もSparse、Dense、Hybrid Retrievalより小さく抑えられました。
これらの結果は、最も高性能なEncoderを使用したり、エージェントに大量の追加検索ターンを与えたりすること以上に、適切に設計されたルーティング構造が重要になり得ることを示しています。
実運用上の考慮事項
Corpus2Skillは、比較的安定した企業内ナレッジコレクションに適しています。
例えば、
- 製品ドキュメント
- ポリシーライブラリ
- テクニカルサポートセンター
- 整理された社内ナレッジベース
などが想定されます。
6,221ドキュメントからなるWixQAの場合、コンパイルには約20分かかります。一度生成されたスキルは、その後多数のクエリに利用できます。
一方、頻繁に更新されるコーパスでは課題が残ります。現在のシステムでは階層をインクリメンタルに修復するのではなく、再コンパイルが必要です。
また、トップレベルでのルーティングミスも依然として最大の失敗要因です。
将来的には、ナビゲーションと検索を動的に組み合わせることが考えられます。
コーパスに明確な分類構造が存在する場合には階層を利用し、そうでないクエリやコレクションではFlat Retrievalへフォールバックする、といった方法です。
今後に向けて
Corpus2Skillは、企業向けRAGを情報検索の問題ではなく、情報ナビゲーションの問題として捉え直します。
リトリーバーに対して孤立した文章を繰り返し要求するのではなく、エージェントにコンパクトな地図を与えます。
エージェントはその地図を基に、どのブランチを探索する価値があるかを判断し、まだどの領域が未探索なのかも把握できます。
より広い視点で見ると、重要なのはLLMが知識へどのようなインターフェースを通じてアクセスするかです。
範囲が限定され、復元可能な構造を持つコーパスでは、その構造自体をモデルに公開することで、サーブ時にベクトルデータベースを使用しなくても、回答品質、根拠カバレッジ、Groundingを改善できる可能性があります。
コード: github.com/dukesun99/Corpus2Skill