



生成型Vision-Language Model(VLM)は、画像の内容を説明したり、画像に関する質問に回答したり、視覚情報と言語情報を組み合わせた意思決定を支援したりできます。一方、人間に関わるユースケースでは、画像内で知覚される人種や性別といった人口統計学的属性だけを意図的に変更した場合でも、モデルが体系的に異なる回答を生成してしまうことがあります。
新たなバイアスが発見されるたびに大規模モデルを再学習することは、コストが高く、現実的でない場合も少なくありません。そこで、より柔軟な選択肢となるのが**推論時デバイアス(inference-time debiasing)**です。モデル自体のパラメータは固定したまま、推論時にのみ内部表現を調整します。
しかし、既存の推論時デバイアス手法の多くは、静的な埋め込み表現やCLIPのようなモデルを前提として設計されています。現代の生成型VLMでは、画像を単一のベクトルとして表現するわけではありません。多数の視覚トークンが言語モデルへ入力され、それぞれのトークンには異なる種類・強度の情報が含まれています。そのため、すべてのトークンに同じ強い補正を適用すると、有用な視覚情報まで失われたり、活性化表現の幾何構造が崩れたり、さらには生成性能そのものが低下したりする可能性があります。
私たちの新しい論文では、この問題に特化した軽量な推論時フレームワーク、**GGSS(Geodesic-Gated Spherical Steering)**を提案します。
GGSSは、反実仮想画像(counterfactual images)から多次元のバイアス部分空間を学習し、人口統計学的属性のシグナルを特に強く含む視覚トークンを特定します。そして、そのトークンのみを、元のノルムを維持したままデバイアスされた方向へ緩やかに回転させます。処理の間、ベースとなるVLMのパラメータは一切変更されません。
生成型VLMには、なぜ異なるデバイアス手法が必要なのか
従来のデバイアス手法を生成型VLMへ適用しようとすると、大きく3つの課題が生じます。
第一に、活性化表現の幾何構造(activation geometry)が重要です。
単純なユークリッド空間上のベクトル減算では、トークンベクトルの方向だけでなく、その長さも変化します。しかし、その後段にあるAttention層やデコーダ層は、元のモデルが持つ活性化分布を前提として学習されています。そのため、このような変更はモデル本来の能力を損なう可能性があり、特にモデル規模が大きくなるほど影響が顕著になることがあります。
第二に、バイアス情報はすべての視覚トークンに均等に分布しているわけではありません。
顔や衣服に対応するトークンには人口統計学的属性に関する情報が含まれる可能性がありますが、背景、ポーズ、画像内の文字などを表すトークンには、そのような情報がほとんど含まれない場合があります。すべてのトークンを同じように投影・補正すると、本来保持すべき有用な情報まで過剰に除去してしまうリスクがあります。
第三に、多くの保護属性(protected attributes)は一次元ではありません。
例えば二値的な性別であれば、場合によっては単一の方向で近似できることがあります。一方、知覚される人種は複数カテゴリにまたがります。そのため、実用的な手法では、単一の普遍的な「バイアス方向」を仮定するのではなく、低次元の部分空間としてモデル化する必要があります。
GGSSは、球面幾何、トークン単位のゲーティング、反実仮想データからの部分空間発見を組み合わせることで、これら3つの課題に対応します。
GGSSの仕組み
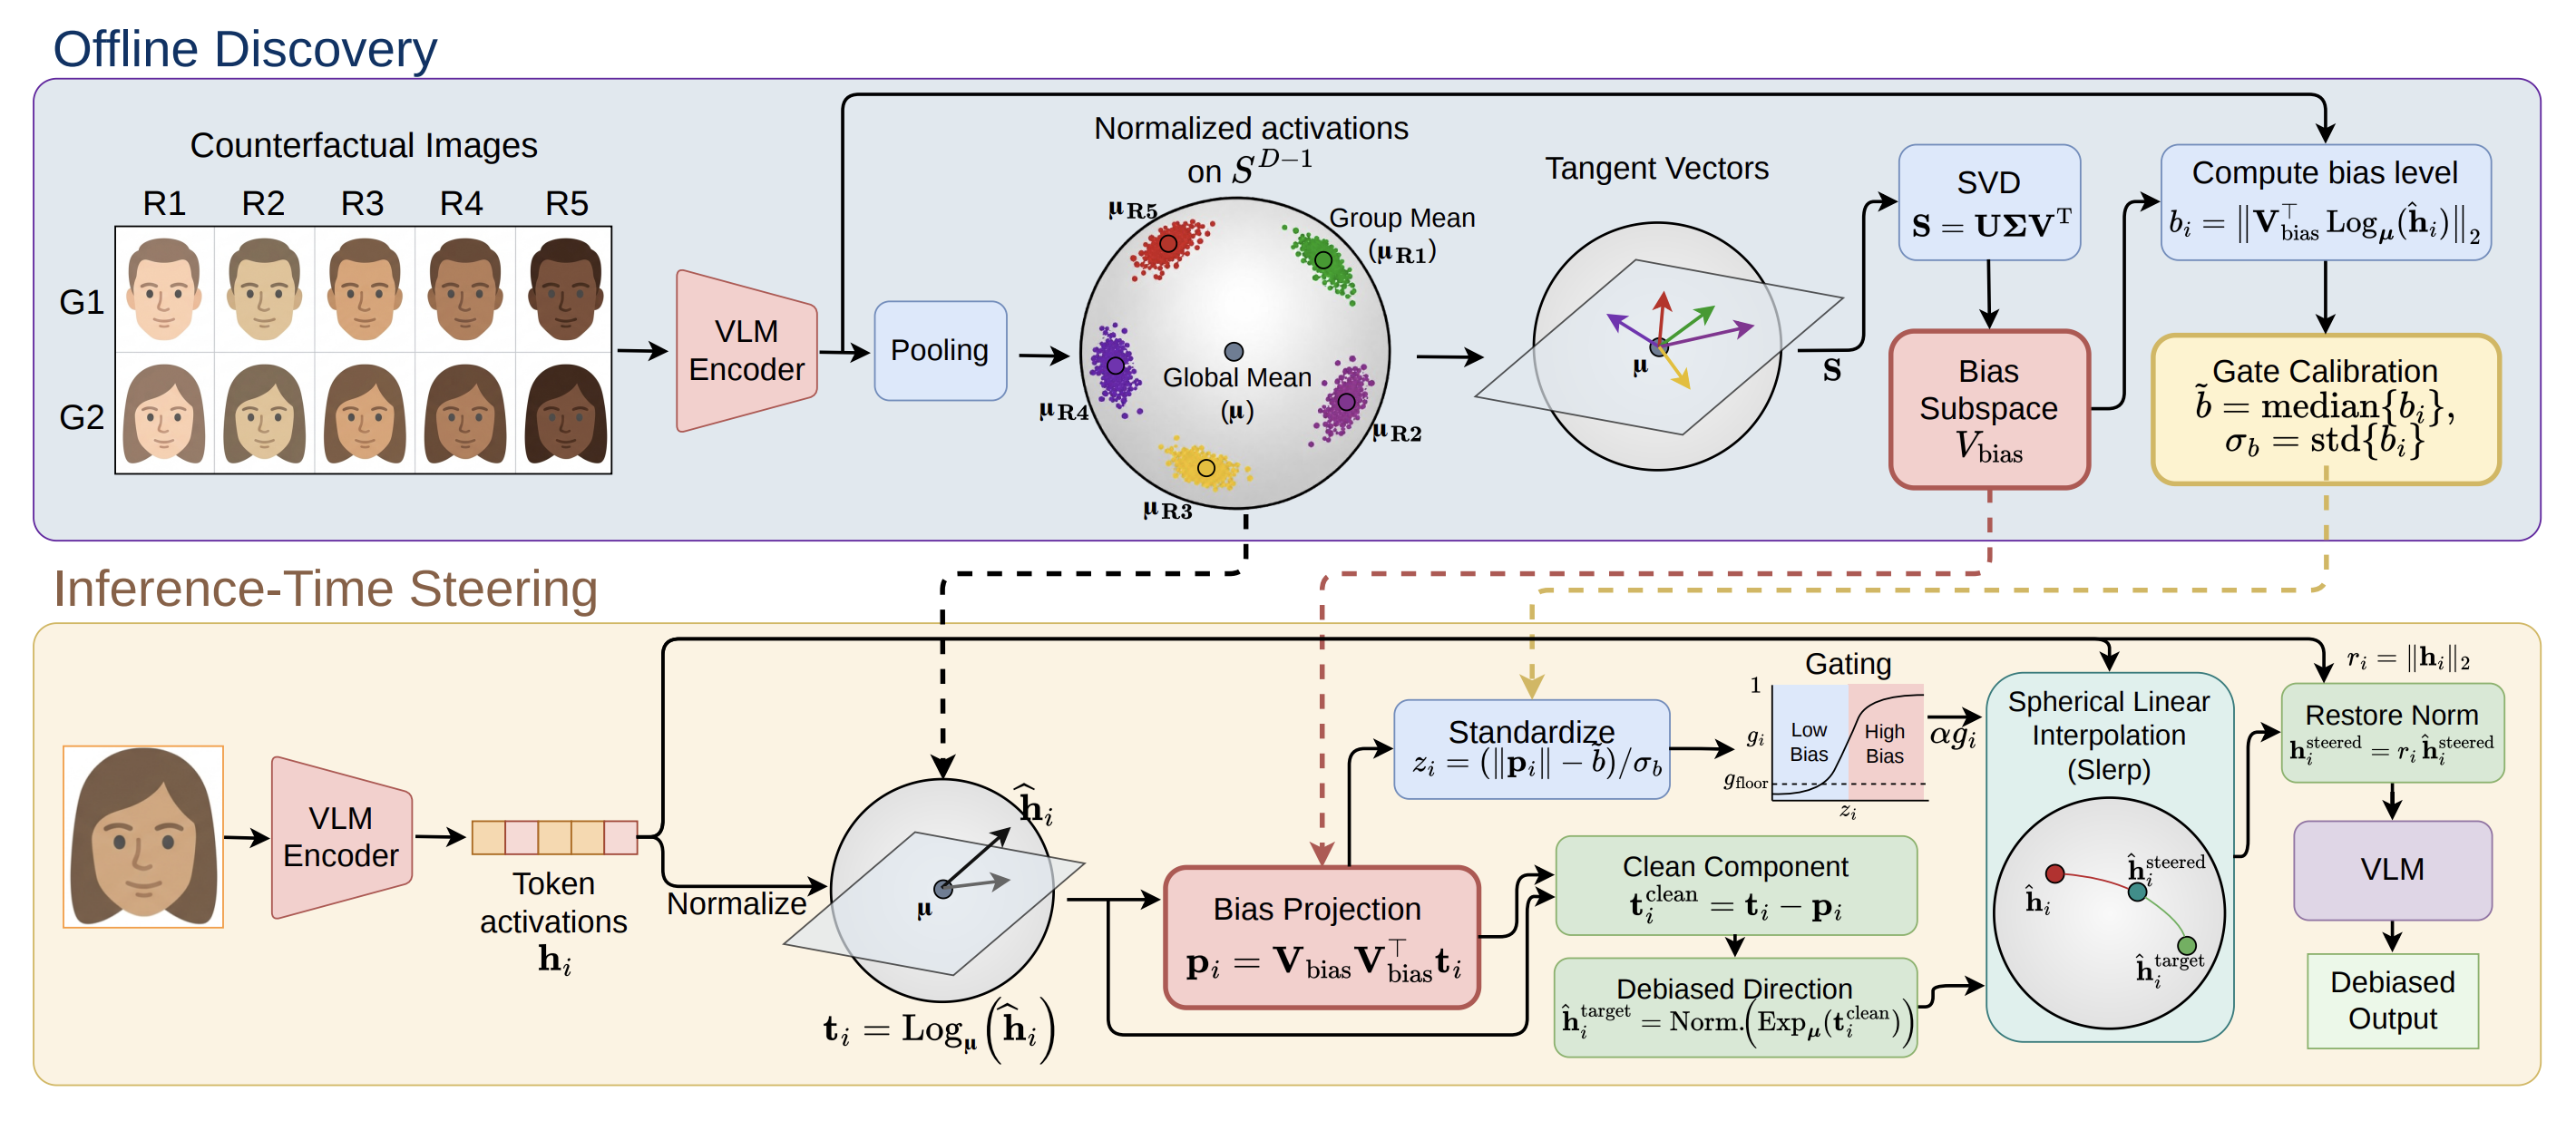
GGSSは、オフラインで行う「発見ステージ」と、軽量な「推論時ステージ」の2段階から構成されます。
1. 反実仮想データからバイアス部分空間を発見する
オフラインの発見ステージでは、慎重に対応付けられた反実仮想画像のセットを、パラメータを固定したVLMに入力します。
各画像セットでは、人口統計学的属性のみを変更し、人物の同一性、職業、ポーズ、服装、背景、照明などは可能な限り同一に保ちます。
得られた視覚活性化をプーリング・正規化した後、その差分を単位超球面上の接空間へ写像し、特異値分解(SVD)を適用します。主要な成分によって、モデル内部表現における人口統計学的変動を捉える多次元部分空間が形成されます。
この方法では、反実仮想画像によって生じる内部活性化の変化そのものからバイアスを学習します。そのため、新たな分類器を学習したり、VLMのパラメータを変更したりする必要はありません。
2. トークンごとにバイアスシグナルを測定する
推論時には、GGSSが各視覚トークンを個別に評価します。
各トークンが、発見ステージで得られたバイアス部分空間にどの程度強く射影されているかを測定し、その大きさを発見ステージで収集した統計値と比較します。
これにより、各トークンに対してキャリブレーションされたゲート値が算出されます。
保護属性のシグナルが通常より強いトークンには、より大きなステアリングを適用します。一方、そのようなシグナルをほとんど含まないトークンについては、元の表現をほぼ維持します。
つまり、GGSSによる介入は一律ではなく、必要なトークンだけを選択的に補正する仕組みになっています。
3. 球面上に沿ってステアリングする
各トークンについて、GGSSは学習した保護属性に対応する成分を除去した目標方向を構築します。
ただし、ユークリッド空間上で直接その目標点へ移動するような強制的な更新は行いません。代わりに、球面線形補間(Spherical Linear Interpolation:Slerp)を利用し、測地線に沿った円弧上を移動させます。
回転後には、トークンが元々持っていた半径、すなわちノルムを正確に復元します。
言い換えると、GGSSではベクトルの大きさを維持したまま、方向のみを変更します。また、単一の強度パラメータ α によって、デバイアスされた目標方向へどの程度強く移動させるかを制御できます。
中心となる考え方はシンプルです。
必要な場所だけをステアリングし、モデルが元々持つ幾何構造に沿って介入する。
評価
GGSSを、3つのモデルファミリー、4Bから12Bまでの異なるモデル規模を含む4種類の生成型VLMで評価しました。
- Pixtral-12B
- LLaVA-1.6-Vicuna-7B
- LLaVA-1.6-Mistral-7B
- Qwen3-VL-4B-Instruct
発見ステージには、REFLECT/FOCUSデータセットに含まれる、ピクセル単位で位置合わせされた480枚の実画像による反実仮想顔画像を使用しました。
評価では、相互に補完的な3種類のバイアス評価プロトコルを使用しています:人種条件付きの給与・教育水準に関する多肢選択タスク;人種の異なる人物をペアにした所得比較タスク;看護師/医師分類におけるジェンダーギャップ評価。
比較対象として、INLP、MeanDiff、BendVLM、LEACEの4つの手法ファミリーから、生成型VLM向けに適応した10種類の推論時ステアリングベースラインを用いました。さらに、プロンプトによるバイアス緩和手法とも比較しています。
すべての手法について、同一の後段Vision-to-Language Projection層に介入し、各モデルにつき1つのステアリング強度を選択して評価しました。
また、一般的なマルチモーダル能力への影響を測るため、知覚、推論、数学、科学を含む1,500問のベンチマークMMStarでも性能を測定しました。
結果:汎用性能を維持しながらバイアスを低減
4モデル全体で比較した結果、GGSSは平均的なバイアス削減量と、ワーストケース性能の両方で最も強い結果を示しました。
4つのバックボーンのうち3つでGGSSが最も高い効果を示しました。PixtralではLEACEの一つのバリエーションが最大の削減量を記録しましたが、他のモデルではGGSSほど安定した結果にはなりませんでした。
GGSSで選択した動作点において、ステアリングを行わない元モデルと比較した平均バイアス変化は以下の通りです。
- Pixtral-12B:−55%
- LLaVA-1.6-Vicuna-7B:−90%
- LLaVA-1.6-Mistral-7B:−80%
- Qwen3-VL-4B:−60%
個別のタスクでは、GGSSによって以下の削減効果が確認されました:Nurse/Doctor分類におけるジェンダーギャップ:最大 96%削減;人種条件付き多肢選択タスクの格差:最大 84%削減;ペア比較タスクにおける人種バイアス:最大 61%削減
さらに重要なのは、一般的なマルチモーダル能力がほぼ維持されている点です。
人種およびジェンダーに対するすべてのステアリング評価において、MMStarの正答率はステアリング前のベースラインに対して**±0.6ポイント以内**に収まりました。
4つのモデルバックボーンのうち3つでは、バイアス削減が統計的に有意でした。一方、8つすべてのステアリング条件において、MMStarの変化はステアリングを行わないモデルと統計的に有意な差がありませんでした。
アブレーション実験からは、その理由についても手がかりが得られています。
Qwen3-VL-4Bでは、トークンゲートを追加することで、ゲーティングを使用しない球面射影よりも性能が向上しました。さらに、ゲートとSlerpを組み合わせた場合に最も高い効果が得られています。
12B規模のモデルでは、幾何的な設計の重要性がより顕著になります。同等条件のユークリッド空間ベースの手法ではMMStar精度が大きく低下した一方、球面ステアリングでは性能を維持できました。
一律に情報を消すのではなく、制御可能な介入を行う
バイアススコアが低下しても、それがモデルから人口統計学的属性を認識する能力そのものを失わせた結果であれば、必ずしも有用とは言えません。
GGSSでは、パラメータ α によって、このトレードオフを明示的に制御できます。
例えばQwen3-VLで中程度の強度を設定した場合、人種認識精度はベースラインから4ポイント以内の低下にとどまりながら、人種条件付き多肢選択タスクでは、実現可能なバイアス削減効果のうちすでに**55%**を達成しました。
また、ある一つの属性に対してステアリングを行っても、評価した4つすべてのバックボーンにおいて、もう一方の属性を認識する能力は維持されました。
このような制御性は、実際のシステム導入において重要です。
人口統計学的情報が判断に影響することを抑えるべきアプリケーションがある一方、属性そのものを正当に記述する必要があるアプリケーションも存在します。後者の場合には、ステアリング強度を弱める、あるいはステアリング自体を無効化するといった運用が可能です。
実用的なVLMデバイアスに向けて
GGSSの結果は、生成型VLMにおける推論時デバイアスを、単純な「グローバルなベクトル除去問題」として扱うべきではないことを示しています。
生成型VLMの表現はマルチトークンで構成されており、対象となる情報はトークン間で不均一に分布しています。さらに、どのような幾何構造に沿って介入するかによって、モデルの能力を維持できるかどうかも変わります。
GGSSは、実運用への適用という観点でも次のような特徴を持っています。
- モデルチェックポイントを固定したまま利用でき、モデル全体の再学習を必要としない
- 多次元の保護属性部分空間に対応できる
- 各視覚トークンについて独立にステアリング強度を調整できる
- 設計上、トークンのノルムを維持できる
- 対象とするバイアスや導入環境の要件が変化しても再設定できる
一方で、ベンチマーク上のバイアス低減が、そのまま完全な公平性を意味するわけではありません。
GGSSは、モデルのパラメータ内部に保持されている偏った知識そのものを除去する手法ではありません。また、今回の評価では、すべてのモデルアーキテクチャ、言語、ドメイン、保護属性、分布シフトを網羅しているわけでもありません。
さらに、使用したデータセットにおける人口統計学的カテゴリは、知覚された属性に基づく評価上のラベルです。個人の自己認識や、人間のアイデンティティが持つ多様性全体を表すものではありません。
そのため、重要な意思決定に関わるシステムへ導入する場合には、ステアリングだけに依存するのではなく、より広範な監査、適切な動作点の明示的な選択、人間による監督、そして残存する、あるいは新たに生じる可能性のある有害な影響に対する継続的なモニタリングを組み合わせる必要があります。
今後の展望
GGSSは、適応的な測地線ステアリングが、生成型VLMを推論時にデバイアスするための実用的な基本手法になり得ることを示しました。
今後の研究課題としては、次のような方向性が考えられます。
- チューニングを必要としないステアリング強度の選択
- 交差的属性(intersectional attributes)に対する評価
- 多言語環境での評価
- より広範な自由生成タスクでの検証
- 人口統計学的属性以外のバイアス部分空間への拡張
より一般的には、今回の結果から、モデルステアリングに関する一つの設計原則が見えてきます。
内部表現が構造化された多様体上に存在し、異なるトークンが異なる情報を担っているのであれば、介入もまた、その情報の幾何構造と局所性の両方を尊重して設計すべきです。
コード: github.com/dukesun99/GGSS